> For the complete documentation index, see [llms.txt](https://docs.flowiseai.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.flowiseai.com/espanol/documentacion-oficial/integraciones/langchain/vector-stores/supabase.md).
# Supabase
## Prerequisitos
1. Registra una cuenta en [Supabase](https://supabase.com/)
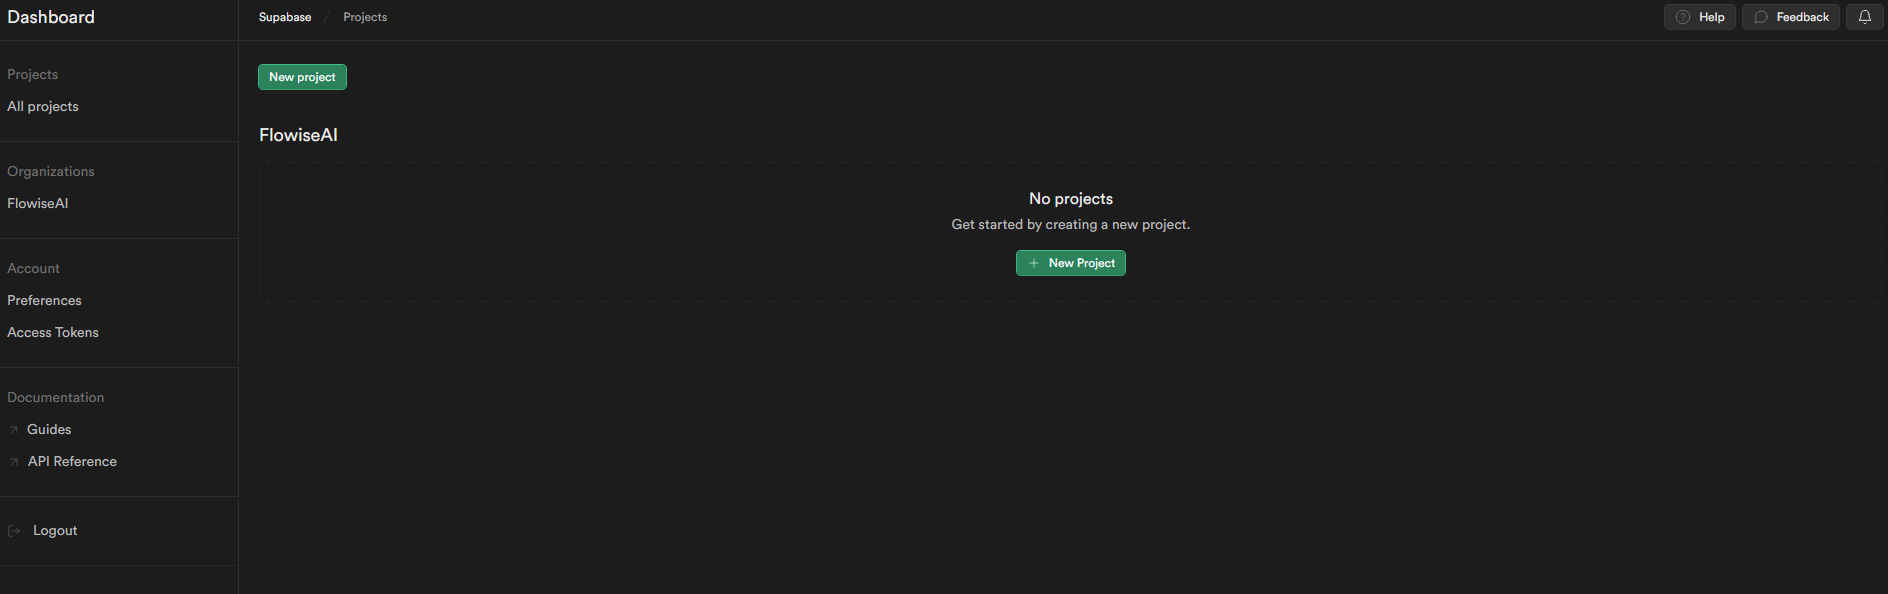
2. Haz clic en **New project**
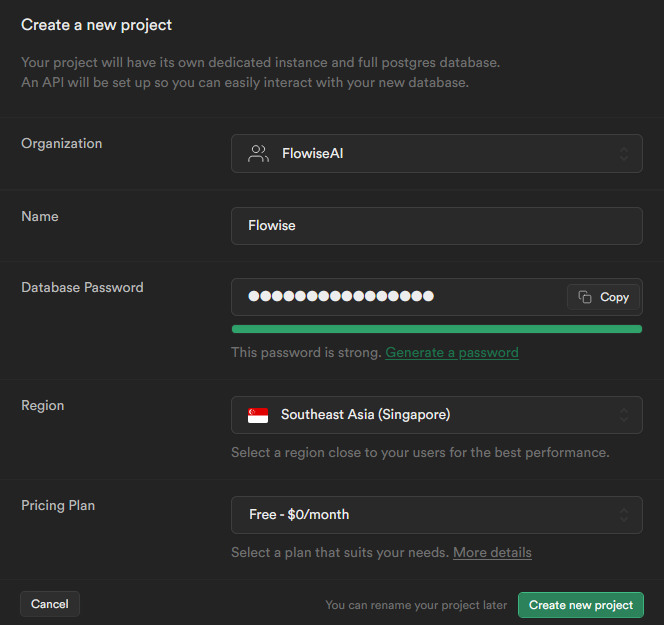
3. Ingresa los campos requeridos
| Nombre del Campo | Descripción |
| ------------------------- | ----------------------------------------- |
| **Name** | nombre del proyecto a crear (ej. Flowise) |
| **Database** **Password** | contraseña para tu base de datos postgres |
4. Haz clic en **Create new project** y espera a que el proyecto termine de configurarse
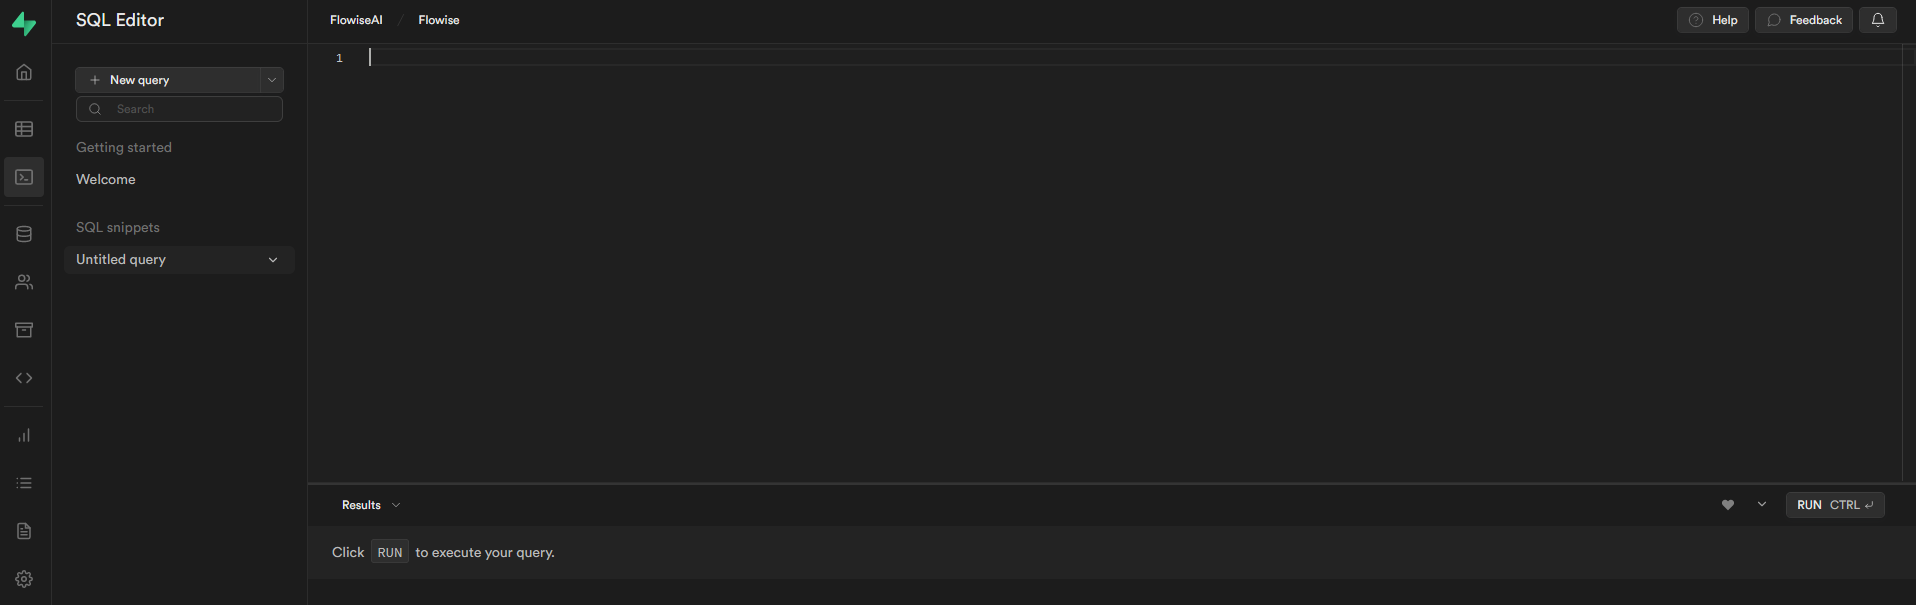
5. Haz clic en **SQL Editor**
6. Haz clic en **New query**
7. Copia y pega la siguiente consulta SQL y ejecútala con `Ctrl + Enter` o haciendo clic en **RUN**. Toma nota del nombre de la tabla y el nombre de la función.
* **Nombre de la tabla**: `documents`
* **Nombre de la consulta**: `match_documents`
```plsql
-- Habilita la extensión pgvector para trabajar con vectores de embeddings
create extension vector;
-- Crea una tabla para almacenar tus documentos
create table documents (
id bigserial primary key,
content text, -- corresponde a Document.pageContent
metadata jsonb, -- corresponde a Document.metadata
embedding vector(1536) -- 1536 funciona para embeddings de OpenAI, cambiar si es necesario
);
-- Crea una función para buscar documentos
create function match_documents (
query_embedding vector(1536),
match_count int DEFAULT null,
filter jsonb DEFAULT '{}'
) returns table (
id bigint,
content text,
metadata jsonb,
similarity float
)
language plpgsql
as $$
#variable_conflict use_column
begin
return query
select
id,
content,
metadata,
1 - (documents.embedding <=> query_embedding) as similarity
from documents
where metadata @> filter
order by documents.embedding <=> query_embedding
limit match_count;
end;
$$;
```
En algunos casos, podrías estar usando [Record Manager](/espanol/documentacion-oficial/integraciones/langchain/record-managers.md) para hacer seguimiento de los upserts y prevenir duplicaciones. Como Record Manager genera un UUID aleatorio para cada embedding, tendrás que cambiar la entidad de la columna id a texto:
```sql
-- Habilita la extensión pgvector para trabajar con vectores de embeddings
create extension vector;
-- Crea una tabla para almacenar tus documentos
create table documents (
id text primary key, -- CAMBIAR A TEXT
content text,
metadata jsonb,
embedding vector(1536)
);
-- Crea una función para buscar documentos
create function match_documents (
query_embedding vector(1536),
match_count int DEFAULT null,
filter jsonb DEFAULT '{}'
) returns table (
id text, -- CAMBIAR A TEXT
content text,
metadata jsonb,
similarity float
)
language plpgsql
as $$
#variable_conflict use_column
begin
return query
select
id,
content,
metadata,
1 - (documents.embedding <=> query_embedding) as similarity
from documents
where metadata @> filter
order by documents.embedding <=> query_embedding
limit match_count;
end;
$$;
```
## Configuración
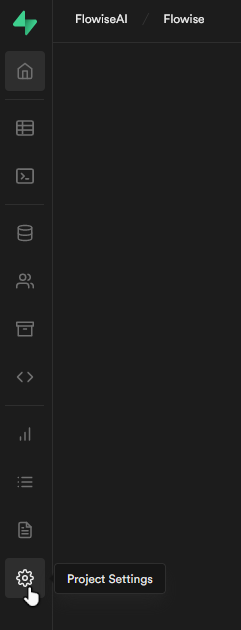
1. Haz clic en **Project Settings**
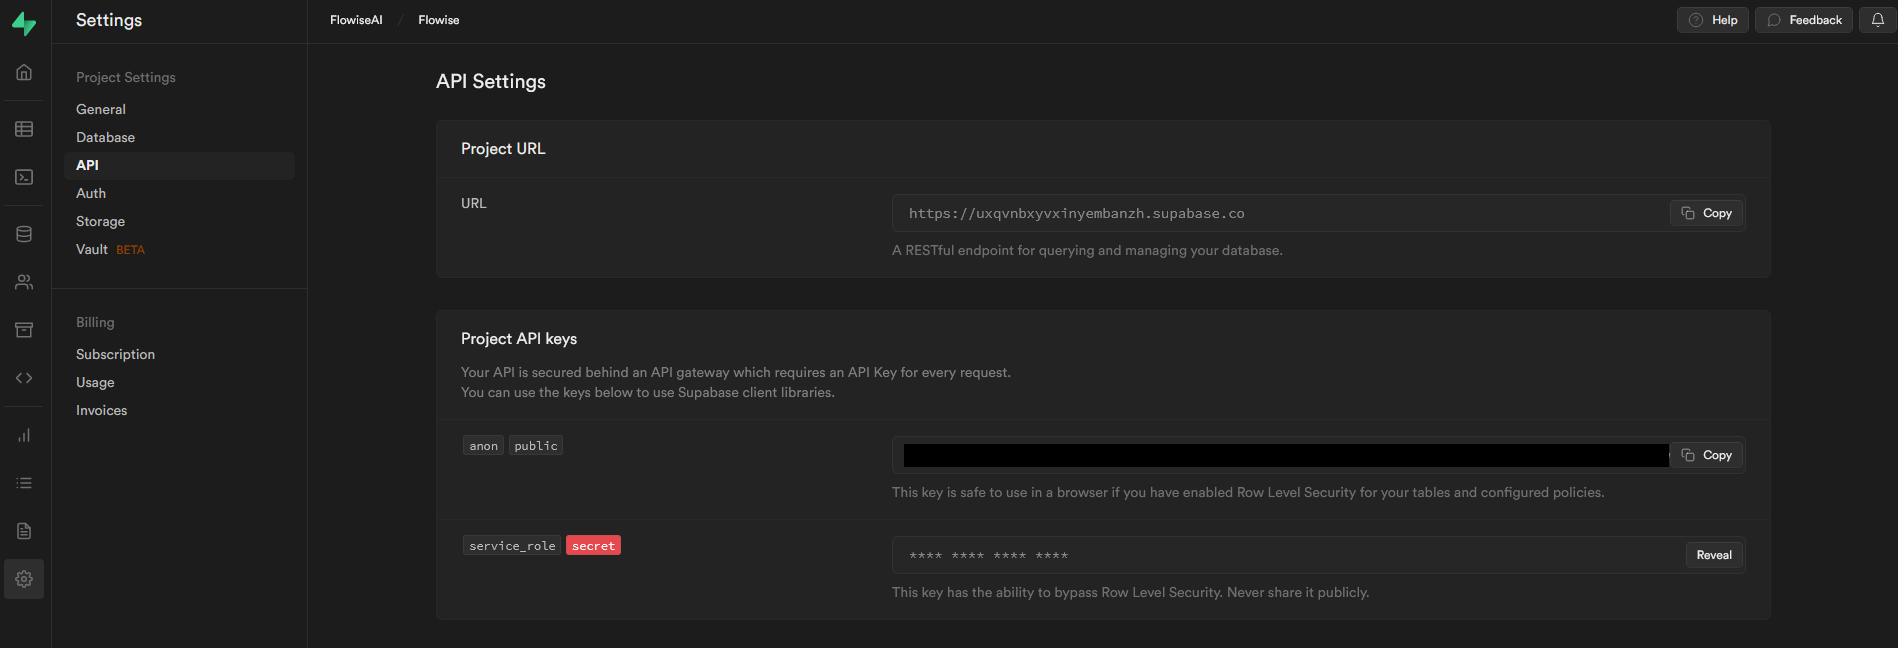
2. Obtén tu **Project URL & API Key**
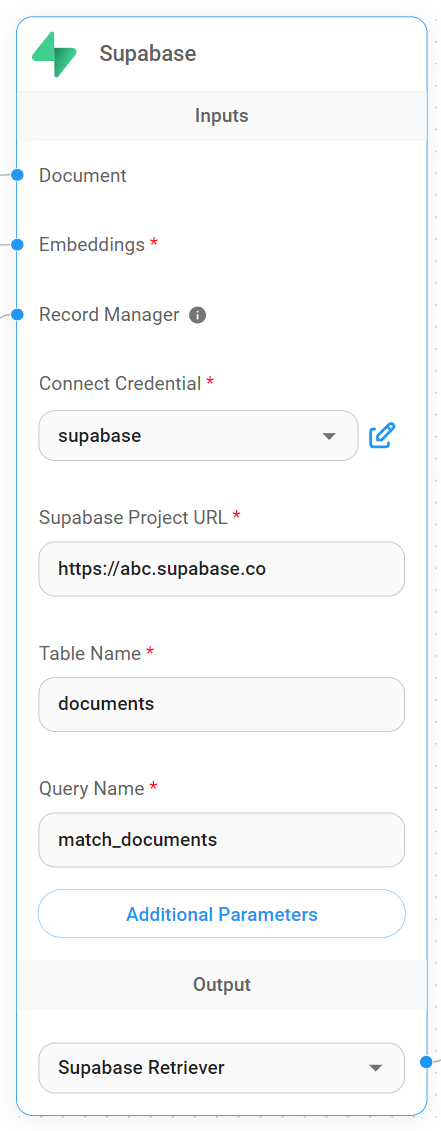
3. Copia y pega cada detalle (*API Key, URL, Table Name, Query Name*) en el nodo **Supabase**
4. **Document** puede conectarse con cualquier nodo de la categoría [**Document Loader**](/espanol/documentacion-oficial/integraciones/langchain/document-loaders.md)
5. **Embeddings** puede conectarse con cualquier nodo de la categoría [**Embeddings**](/espanol/documentacion-oficial/integraciones/langchain/embeddings.md)
## Filtrado
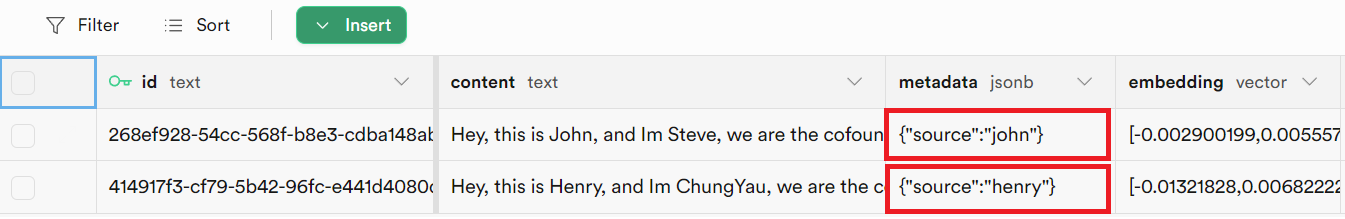
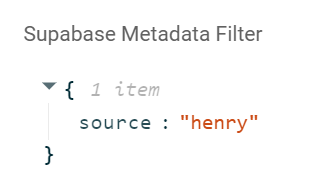
Supongamos que tienes diferentes documentos insertados, cada uno especificado con un valor único bajo la clave de metadata `{source}`
Puedes usar filtrado de metadata para consultar metadata específica:
**UI**
**API**
```json
"overrideConfig": {
"supabaseMetadataFilter": {
"source": "henry"
}
}
```
## Recursos
* [LangChain JS Supabase](https://js.langchain.com/docs/modules/indexes/vector_stores/integrations/supabase)
* [Supabase Blog Post](https://supabase.com/blog/openai-embeddings-postgres-vector)
* [Metadata Filtering](https://js.langchain.com/docs/integrations/vectorstores/supabase#metadata-filtering)